logo Galexie
Galexie
Références
Machine Learning / apprentissage automatique

Exemples d'utilisation d'algorithmes d'apprentissage automatique

Situation : catégoriser des élèves et des exercices.
Format CSV

Résultats aléatoires

Générer un contenu de fichier au format CSV

Choisissez le nombre d'élèves et le nombre de résultats à des exercices fictifs à créer.

créer du contenu aléatoirement

K-Means

Fichier .CSV

Catégoriser des élèves selon leurs résultats

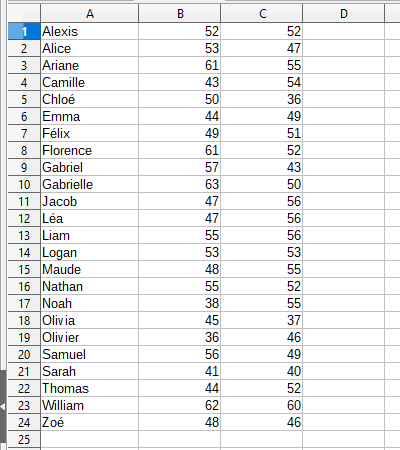
Téléchargez un fichier au format .CSV afin de regrouper des élèves selon leurs résultats. La première colonne doit contenir leur nom (ou toute autre chaîne de caractères permettant de les distinguer) et les colonnes suivantes doivent contenir leurs notes. Exemple :

tester K-Means

K-Means

Fichier .CSV

Catégoriser des exercices selon les résultats des élèves

Téléchargez un fichier au format .CSV afin de regrouper des élèves selon leurs résultats. La première colonne doit contenir leur nom (ou toute autre chaîne de caractères permettant de les distinguer) et les colonnes suivantes doivent contenir leurs notes. Exemple :

tester K-Means

Aperçu de quelques algorithmes d'apprentissage automatique

Illustrations : Wikipedia.

Variables

  • Variables qualitatives ou catégorielles : Représentent des états et prennent la forme d'étiquettes.
  • Variables quantitatives : Mesurent avec des nombres. Valeurs discrètes (valeurs finies) ou continues (valeurs infinies).
sont des étiquettes sont des valeurs
ne se suivent pas nominales
(nom, sexe, ...)
de ratios
(distance, durée, ...)
se suivent ordinales
(1er, 2ème, échelle de Likert, ...)
d'intervalles
(date, température, ...)

Terminologie


supervisé
Des exemples sont fournies à l'algorithme par le chercheur.
classification
Variables qualitatives (catégorielles) : catégories fournies par le chercheur. Génère des valeurs discrètes.
regression
Variables quantitatives : estimer les relations entre variables. Génère des valeurs continues.
non-supervisé
Les exemples ne sont pas fournis à l'algorithme.
association
Variables qualitatives : découvrir les regroupements entre variables.
clustering
Variables quantitatives : les catégories sont générées par l'algorithme.
type d'apprentissage : supervisé
type d'organisation : classification

K-NEAREST NEIGHBORS

Classification par proximité

La méthode des k plus proches voisins catégorise les objets en fonction de leur proximité mutuelle, les considèrant alors comme similaires.
Paramètres : étiquettes des catégories et valeurs des objets.

tester K-nearest neighbors

type d'apprentissage : supervisé
type d'organisation : classification

NAIVE BAYES

Classification par caractéristiques

La classification naïve bayésienne catégorise les objets en fonction de leurs caractéristiques. Les caractéristiques de chaque catégorie sont indépendantes les unes des autres.
Paramètres : étiquettes des catégories et caractéristiques des objets.

tester Naive Bayes

type d'apprentissage : supervisé
type d'organisation : regression

LEAST SQUARES

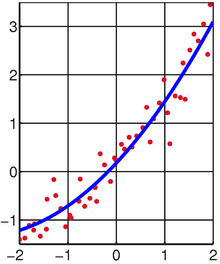
Dégager la tendance des données

La méthode des moindres carrés ("Least Squares") prend en compte une série d'objets afin d'en déduire une fonction.
Paramètres : caractéristiques des objets et étiquettes correspondantes.

tester Least Squares

type d'apprentissage : non-supervisé
type d'organisation : association

A-PRIORI

Compléter un assortiment

Associe les objets en fonction des caractéristiques récurrentes.
Paramètres : listes complètes d'objets et une liste incomplète.

tester A-priori

type d'apprentissage : non-supervisé
type d'organisation : clustering

K-MEANS CLUSTERING

Regroupement par proximité

Répartit des objets en plusieurs groupes (ou clusters). Est pris en compte la distance d'un objet par rapport à la moyenne des positions des objets du groupe.
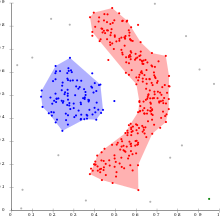
Paramètres : coordonnées des objets et nombre de groupes (clusters).

tester K-Means clustering

type d'apprentissage : non-supervisé
type d'organisation : clustering

DBSCAN CLUSTERING

Regroupement par proximité et quantité

"Density-based spatial clustering of applications with noise" répartit les objets en plusieurs groupes (clusters) selon la distance les séparant, leur densité et un nombre minimum d'objets voisins pour y considérer l'un d'eux comme le centre.
Paramètres : epsilon = distance maximale autorisée entre deux objets; minPoints = nombre minimal d'objets voisins.

tester DBSCAN clustering

Exemples

K-NEAREST NEIGHBORS NAIVE BAYES LEAST SQUARES A-PRIORI K-MEANS CLUSTERING DBSCAN CLUSTERING
échantillon de ratios
[[1, 3], [1, 4], [2, 4], [3, 1], [4, 1], [4, 2]]
de ratios
[[5, 1, 1], [1, 5, 1], [1, 1, 5]]
ordinales
[[60], [61], [62], [63], [65]]
nominales
[['alpha', 'beta', 'epsilon'], ['alpha', 'beta', 'theta'], ['alpha', 'beta', 'epsilon'], ['alpha', 'beta', 'theta']]
de ratios
[[1, 1], [8, 7], [1, 2], [7, 8], [2, 1], [8, 9]]
de ratios
[[1, 1], [8, 7], [1, 2], [7, 8], [2, 1], [8, 9]]
étiquettes nominales
['a', 'a', 'a', 'b', 'b', 'b']
nominales
['a', 'b', 'c']
valeurs de ratios
[3.1, 3.6, 3.8, 4, 4.1]
question [3, 2] [3, 1, 1] [64] ['alpha','theta'] epsilon = 2, minSamples = 3
réponse b a 4.06 beta [0=>[[1, 1], ...], 1=>[[8, 7], ...]] [0=>[[1, 1], ...], 1=>[[8, 7], ...]]

Références

Lortet, A. (2019). Apprentissage automatique [Application en ligne]. Repéré à https://ml.galexie.com

Les algorithmes utilisés proviennent de la bibliothèque PHP-ML d'Arkadiusz Kondas.

Kondas, A. (2016). Fresh approach to Machine Learning in PHP. Repéré à https://github.com/php-ai/php-ml